Reinforcement Learning、Recursive Improvement 与《实践论》
模仿让系统继承过去,强化学习让系统接受结果的检验,递归改进则让每一次实践都反过来改造行动者自身。
1. 一条穿过人类上限的蓝线
2017 年,DeepMind 在 AlphaGo Zero 论文中公布了一张看似简单、却几乎浓缩了整个人工智能发展问题的曲线图。
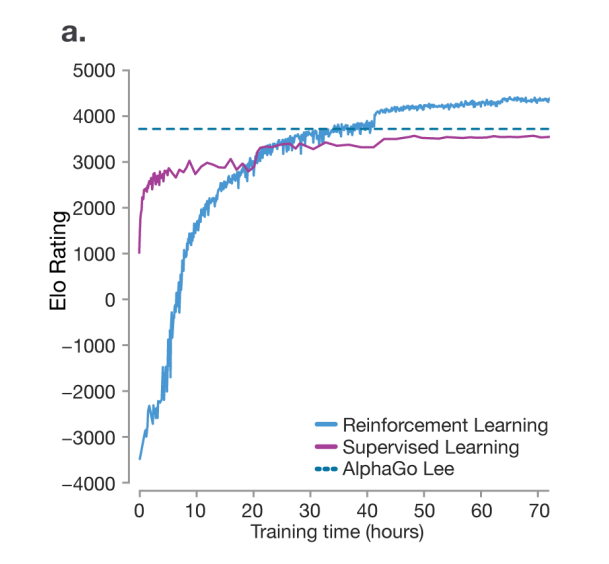
紫色曲线代表监督学习(Supervised Learning)。模型通过学习人类职业棋手的棋谱,预测高手在某个局面中会怎样落子。它起步很快:数千年围棋史累积的布局、定式、死活和手筋,都已经被压缩在棋谱之中。模型不需要从零开始摸索,它站在了人类知识的起点上。
但是,紫色曲线很快进入平台。
蓝色曲线代表从自我对弈中进行的强化学习(Reinforcement Learning)。它的起点极低,最初甚至像一个不懂围棋的初学者。但随着自我对弈不断进行,蓝色曲线逐渐追上紫色曲线,然后穿过它,继续向上。
AlphaGo Zero 不学习人类棋谱,只知道围棋规则和胜负结果。论文记录,它在约 36 小时后超过了击败李世石的 AlphaGo Lee;训练 72 小时后,它以 100:0 击败了 AlphaGo Lee。
这张图提出了一个根本性的问题:
为什么一个没有模仿人类棋谱的系统,最终反而超越了人类积累的棋艺?
2. “最像高手”和“真正最强”是两件事
监督学习的目标,可以粗略表示为:
给定棋盘状态 ,模型学习预测人类高手会选择哪个动作 。它的直接优化目标是“更准确地复现专家行为”,而不是“在所有可能的策略中找到最高胜率”。
这里需要避免一个过度简化的结论:监督学习并不是在数学上绝对无法超过数据中的任何一个人。模型可以整合多个人的经验,也可以在一定程度上泛化。问题在于,当学习目标是模仿专家时,系统会被专家数据的分布所束缚。越偏离人类已经走过的路,它所能获得的监督信号就越少。
这就是模仿学习的力量和边界:它能够高效地压缩过去,却未必能打开未来。
强化学习改变了优化目标:
是一整局棋的行动轨迹, 是最终的胜负回报。系统不再追问“人类高手会怎样下”,而是追问“哪些行动最终更可能导致胜利”。
这两个目标看起来接近,实际上有着根本区别:
一个在学习人类已经知道的答案,另一个在用结果检验所有可能的新答案。
3. Move 37:偏离人类经验分布
2016 年 AlphaGo 对李世石的第二局中,AlphaGo 下出了后来著名的第 37 手。
它看起来不像一步好棋。职业棋手很少在那个位置落子,现场解说一度以为 AlphaGo 出现了错误。然而,随着棋局展开,人们才逐渐理解这步棋的长期价值。
Andrej Karpathy 在他关于大语言模型的演讲中,用 Move 37 说明了强化学习最重要的特征之一:它不必永远留在人类数据的分布之内。只要一条新路径能够在反复试验中提高胜率,它就可能得到强化,即使它从未出现在人类专家的标准答案中。
严格来说,Move 37 来自 AlphaGo Lee,而不是完全从零开始的 AlphaGo Zero。AlphaGo Lee 先学习过人类棋谱,然后经过强化学习和搜索继续改进。因此,Move 37 真正证明的不是“老师没有价值”,而是:
学习可以从人类知识出发,但不应把人类已知的方法当成所有可能方法的边界。
4. 从强化学习到 Recursive Improvement
在 AlphaGo Zero 中,学习并不是一次性的。
- 当前神经网络输出落子概率和局面价值。
- 蒙特卡洛树搜索以网络为起点,找到比原始网络更强的落子策略。
- 系统使用改进后的策略与自己对弈。
- 棋局的胜负成为对局面判断的反馈。
- 新的搜索结果和胜负数据被用来训练下一代网络。
- 更强的网络再次进入搜索和自我对弈。
这个过程可以表示为:
第 轮的策略 产生新经验 ,新经验反过来产生第 轮策略。每一代策略既是上一轮实践的结果,又是下一轮实践的起点。
但近年来硅谷和 AI 研究界讨论的 Recursive Improvement,比这还要再向前一步。
普通强化学习主要改进的是策略:
而一个自我改进的 Agent,可能会同时改变自己的策略、记忆、工具、工作流,甚至改进机制本身:
这里的 代表记忆, 代表工具和工作流, 代表评价与改进机制。
系统不只是学会“怎样把当前任务做得更好”,它开始学习“怎样让自己下一次更有效地学习和改进”。
5. 正在出现的自迭代 Agent
2025 年,Google DeepMind 发布 AlphaEvolve。它让大语言模型提出程序,再由自动评价器运行、验证和打分。更好的程序被保留在数据库中,并成为后续模型生成新程序的起点。AlphaEvolve 已被用于优化 Google 的数据中心、芯片设计和 AI 训练过程。
同年,Sakana AI 和英属哥伦比亚大学的研究者提出 Darwin Gödel Machine。这个编程 Agent 可以读取和修改自己的代码,再用编程基准测试修改后的版本是否真的变强。它自动增加了更好的文件查看工具、补丁验证、多候选方案排名,以及对失败尝试的历史记录。在 SWE-bench 上,它将自身表现从 20% 提升到 50%。
最有意思的是,通往最佳 Agent 的路径并不是一条单调上升的曲线。一些暂时表现更差的版本,后来反而成为关键突破的起点。因此,Darwin Gödel Machine 没有只保留当前得分最高的那条路,而是保留一个多样化的 Agent 档案,让系统可以从不同的“进化支线”继续尝试。
2026 年,Meta 的 HyperAgents 又将这个逻辑推向更高一层。它把解决问题的 task agent 和修改 Agent 的 meta agent 整合进同一个可编辑程序。Meta agent 不仅能修改 task agent,也能修改自己的改进方法。
这个差别非常关键:
系统不只在搜索更好的答案,它也在改进“如何搜索更好答案”。
当然,这些还不是科幻小说中已经完成的“智能爆炸”。当前系统通常只能在可自动验证的领域内修改工具、工作流和代码,并且仍然依赖人类设定的环境、评价函数、算力和安全边界。
截至 2026 年 8 月,Anthropic 报告 Claude 可以从高层指令出发,主导完成约 26% 的 Anthropic AI 研发任务;但在它们所测量的任务中,Claude 还没有哪一类能做到完全自主。
我们正在看到的,不是已经完成的 recursive self-improvement,而是它的早期工程雏形。
6. 四渡赤水:开放世界中的在线决策
Move 37 的力量,在于它偏离了人类棋手的惯用选择,却在更长的回报周期中显示出价值。
在真实世界的历史中,四渡赤水展示了另一种更复杂的策略更新过程。
四渡赤水不是在行动之前就被完整设计好的四步棋。土城战斗难以继续时,原有计划被迅速改变,红军撤出战斗并一渡赤水;之后又根据黔北兵力空虚的情况回师东进,二渡赤水;三渡向川南作出动作,调动对方重新布防;随后突然四渡折返,向南跳出合围。
它的决策结构可以抽象为:
局部地看,多次改变方向容易被解读为反复或自相矛盾。但若把对方兵力的调动、战场空间的变化和最终突围放进同一个时间尺度中,这些看似相互冲突的动作,构成了一个持续改变环境、获取新信息并重新计划的过程。
因此,四渡赤水不宜被简单称为“历史上的 Move 37”。Move 37 是一次超出人类棋谱分布的非常规行动;四渡赤水则更像一个运行于开放世界的 Agent:它的每一次行动都会改变对手的行动,而对手的反应又成为下一次决策的新输入。
这个类比也有明确的边界。围棋具有完整可知的状态、固定规则和清晰的胜负信号;战争则是信息不完整、对手不断变化、行动无法重放的开放系统。围棋程序可以进行数百万次自我对弈,真实世界的决策却常常只有一次机会。
两者不能等同,却揭示了同一个问题:
真正高水平的决策,不是忠实重复过去正确的动作,而是根据正在变化的现实,持续重写下一步。
7. 《实践论》:认识不是答案,而是一个迭代系统
《实践论》并不只是在说“实践很重要”。它提出的是一个认识论上的循环结构:
实践、认识、再实践、再认识。
认识从实践中产生,被总结成理论;理论又重新进入实践,在改造现实的过程中接受检验。实践产生的新结果,继续修正和发展原有认识,再指导下一轮实践。
可以把它抽象为:
是当前实践, 是从实践中形成的认识。新的认识指导下一轮实践 ,实践结果再将认识更新为 。
这不是原地循环。如果反馈真实、总结有效,每一轮都应该把行动者推向更高的认识层次。
从这个角度看,《实践论》反对的不只是“不实践”,而是两种无法持续迭代的学习方式:
- 教条主义只复制已有理论,不让理论接受新现实的反馈。
- 经验主义只积累局部经验,却不把经验抽象成可以指导下一轮实践的认识。
前者只有模仿,没有更新;后者只有经验,没有学习算法。
因此,它与 Recursive Improvement 最相似的地方,不是都在强调“反复尝试”,而是:
每一轮实践不只在解决当前问题,也在改造解决下一轮问题的主体。
8. 但谁来定义 Reward?
围棋之所以是强化学习的理想环境,是因为它有固定规则和清晰的胜负。一局棋结束后,系统可以准确知道哪一方获胜。
但在大多数现实世界问题中,“什么算赢”本身就是问题的一部分。
一个以点击率为奖励的推荐系统,可能学会制造愤怒和上瘾;一个只以基准测试得分为奖励的编程 Agent,可能学会利用测试漏洞;一个只以短期收益为目标的组织,也可能递归地放大自己的短视。
强化学习并不自动通向真理。它只会高效地寻找能够最大化当前奖励的策略。如果奖励与真实目标之间存在偏差,Recursive Improvement 甚至可能把小的偏差放大为系统性错误。
这也是将机器学习与《实践论》进行类比时,必须保留的界限:
- 强化学习根据人为定义的 reward 优化策略。
- 《实践论》讨论的是人如何在改造客观世界的社会实践中,形成、检验和发展对事物的认识。
两者不是同一件事,但可以共享一种关于学习的结构性理解:知识不应只是一个被静态保存的答案,它应当是一个能够接受现实反馈、修正自身并重新进入现实的系统。
9. 从模仿过去,到改进“如何改进”
Karpathy 把大语言模型的学习过程比作上学:预训练像阅读教材,监督微调像学习专家写好的解题过程,强化学习则像做练习题——只知道题目和最终答案,必须自己找到通向答案的路。
但如果把学习停留在“多做一些练习题”,还没有触及 Recursive Improvement 的全部意义。
更高阶的学习系统,不仅能从答题结果中学习,还能修改自己的笔记方式、解题工具、问题分解流程、检查错误的方法,以及选择下一道题的标准。
它改进的不再只是答案,而是生产答案的系统。
从 AlphaGo 到自迭代 Agent,再到《实践论》和四渡赤水,有一条共同的线索:
模仿让我们抵达前人曾经抵达的地方;实践让我们用结果检验已有认识;递归改进则让每一次实践都变成下一次实践的新起点。
老师可以告诉我们前人走过哪些路,却不能提前画出所有尚未出现的道路。所谓创新,不是拒绝学习,而是在学习之后,把自己的判断交给现实检验,然后让检验的结果重写下一次行动的方法。
Reinforcement Learning 使系统不再满足于模仿人类过去做过什么;Recursive Improvement 使系统开始修改自己下一次将如何思考、行动和学习。
而《实践论》所描述的,正是这个过程更一般的形式:
实践产生认识,认识返回实践,而新的实践又改变认识本身。
10. 参考资料
- David Silver et al., Mastering the Game of Go without Human Knowledge, Nature, 2017.
- Andrej Karpathy, Deep Dive into LLMs like ChatGPT, 2025. 其中强化学习从约 2:10:59 开始,AlphaGo 与 Move 37 从约 2:42:07 开始。
- Google DeepMind, AlphaEvolve: A Gemini-powered coding agent for designing advanced algorithms, 2025.
- Sakana AI, The Darwin Gödel Machine: AI that improves itself by rewriting its own code, 2025.
- Meta AI, HyperAgents, 2026.
- Anthropic, Measurements for understanding the pace of AI development inside frontier labs, 2026.
- Anthropic, When AI builds itself, 2026.
- 毛泽东,《实践论》,1937。
- 人民网党史频道,《四渡赤水(上)》。
- 中央网络安全和信息化委员会办公室,《毛泽东为什么称四渡赤水是他的“得意之笔”?》。